A mentira confortável do "staging é espelho de produção"
Todo roadmap tem um momento místico em que alguém da gestão garante que o ambiente de homologação é idêntico ao de produção. Na prática, homologação tem 140 registros criados no seed de 2023, zero bots fazendo scraping, latência de localhost e um Redis que reinicia toda terça-feira.
Quando você aperta merge na sexta às 17h59 com 42 checks verdes no CI, o código não está validando a realidade; ele só provou que consegue compilar e responder HTTP 200 para três usuários simultâneos no mesmo fuso horário.
As 4 falhas exatas que derrubam o servidor às 18h01
Se o alarme do Slack tocou antes mesmo de você fechar a mochila, a causa quase sempre mora em um destes quatro pontos de falha clássicos:
- 1. Migration bloqueante (AccessExclusiveLock): adicionar coluna com default não-nulo ou criar índice sem CONCURRENTLY em tabela gigante congela todas as queries de leitura e escrita até estourar o pool de conexões.
- 2. Cache travado com schema antigo: o novo container sobe lendo uma propriedade extra do objeto JSON salvo no Redis pelo container antigo, causando TypeError silencioso em metade dos requests.
- 3. Environment drift e secrets fantasma: a variável NEW_GATEWAY_TIMEOUT existe no .env.staging desde agosto, mas ninguém subiu no cofre de produção.
- 4. Efeito manada no cold start: dezenas de instâncias reiniciam juntas, invalidam o cache ao mesmo tempo e disparam um thundering herd direto no banco primário.
-- ERRADO às 17h59 de sexta-feira: trava a tabela inteira em produção
ALTER TABLE pedidos ADD COLUMN status_faturamento TEXT NOT NULL DEFAULT 'PENDENTE';

-- MENOS TRAUMÁTICO: operação em fases (expand-and-contract)
ALTER TABLE pedidos ADD COLUMN status_faturamento TEXT;
CREATE INDEX CONCURRENTLY idx_pedidos_faturamento ON pedidos (status_faturamento);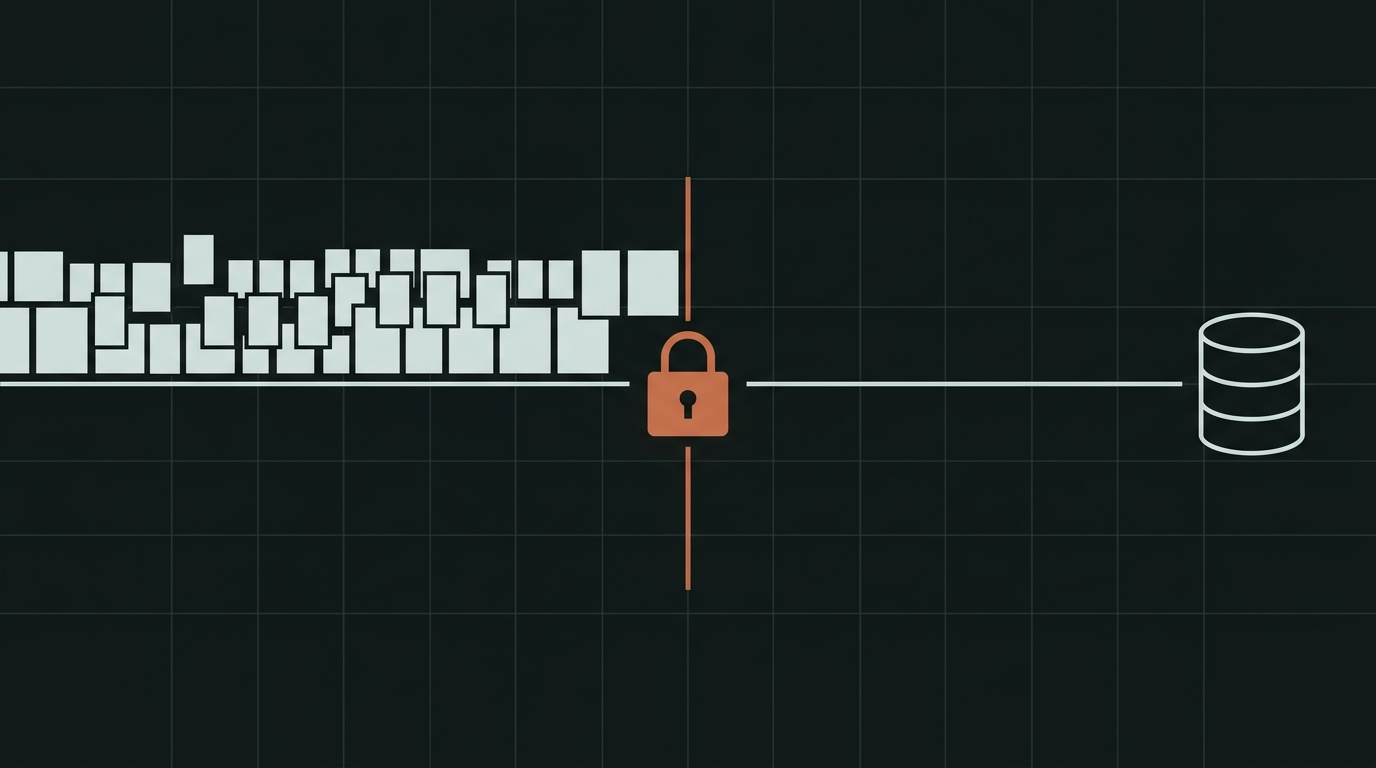
A lei termodinâmica da sexta-feira às 17h59
Não é azar metafísico. Sexta-feira concentra o acúmulo de PRs segurados durante a semana para "fechar a sprint antes da review". Com seis features empilhadas no mesmo release train, a chance estatística de conflito entre uma migration de um squad e o endpoint de outro se aproxima de 100%.
Resultado conhecido: você passa o começo do fim de semana olhando tail de log com café frio na mão, enquanto quem pediu urgência no deploy já desligou o celular até segunda às 10h.
Checklist frio antes de apertar Merge (ou recusar o deploy)
Enquanto o mundo corporativo não descobre que software não segue calendário de planilha, proteja o seu fim de semana aplicando travas objetivas no pipeline:
- Trava de horário no CI/CD após quinta-feira 16h00 exigindo aprovação explícita de on-call.
- Versionamento obrigatório de chaves de cache (ex: v4:user:123) sempre que o payload mudar.
- Feature flags separando deploy físico (subir binário) de release comercial (ativar para usuários).
- Camiseta SeQueLa vestida na câmera na segunda-feira para poupar saliva quando perguntarem como foi o fim de semana.
Homologação vs. Produção vs. Promessa do Gerente
| Variável Crítica | Ambiente de Homologação | Produção às 17h59 | Como o PM Descreveu |
|---|---|---|---|
| Linhas na tabela principal | 412 registros de seed | 48.700.000 linhas | "É só uma tabelinha simples" |
| Estado do Redis / Cache | Reiniciado ontem | Chaves de 4 versões atrás | "Limpa sozinho, né?" |
| Concorrência simultânea | 1 QA testando um fluxo | 3.400 requests/min + bots | "Uso bem leve hoje" |
| Rollback disponível | Instantâneo (sem dado real) | Migration já alterou coluna | "Se der ruim a gente volta" |
Leia também
- Microgerenciamento disfarçado de Metodologia Ágil e Daily Scrum
Entenda como a pressão de fechar cards no Jira empurra deploys quebrados para sexta à tarde.
- Glossário Dev: Drift de Homologação
Definição técnica de como diferenças silenciosas entre staging e produção causam incidentes.
- Calculadora de Risco de Deploy na Sexta-Feira
Meça a probabilidade exata de rollback antes de aprovar o Pull Request.
Perguntas Frequentes (FAQ)
Vale a pena proibir deploy na sexta-feira ou isso é sinal de infraestrutura fraca?
Se o seu time possui feature flags reais, canary deployment automático, zero-downtime migrations e rollback em menos de 60 segundos sem intervenção humana, sexta é um dia comum. Se o rollback envolve restaurar snapshot manual e pedir desculpas no Slack, proibir deploy na sexta é pura autodefesa.
Por que erros de cache travado nunca aparecem nos testes automatizados do CI?
Porque a suíte do CI sobe um container limpo do zero para cada execução. Ela jamais simula a transição em que o container V2 lê um dado gravado há 4 horas pelo container V1 dentro do mesmo Redis compartilhado.
Qual o primeiro comando para rodar quando o CPU do banco bate 100% após o deploy?
Verifique queries aguardando lock há mais de poucos segundos (no PostgreSQL, consulte pg_stat_activity filtrando wait_event_type = Lock). Matar a migration travada ou o processo bloqueador costuma devolver o respiro antes mesmo do rollback completo.
Referências e Fontes
- Google SRE Book — Postmortem Culture & Release Engineering — Google Site Reliability Engineering
- PostgreSQL Documentation — Explicit Locking & Concurrent Index Creation — PostgreSQL Global Development Group